Una IA entrenada para manejar un robot puede transformarlo en un arma mortal con un par de instrucciones erróneas
INTELIGENCIA ARTIFICIAL.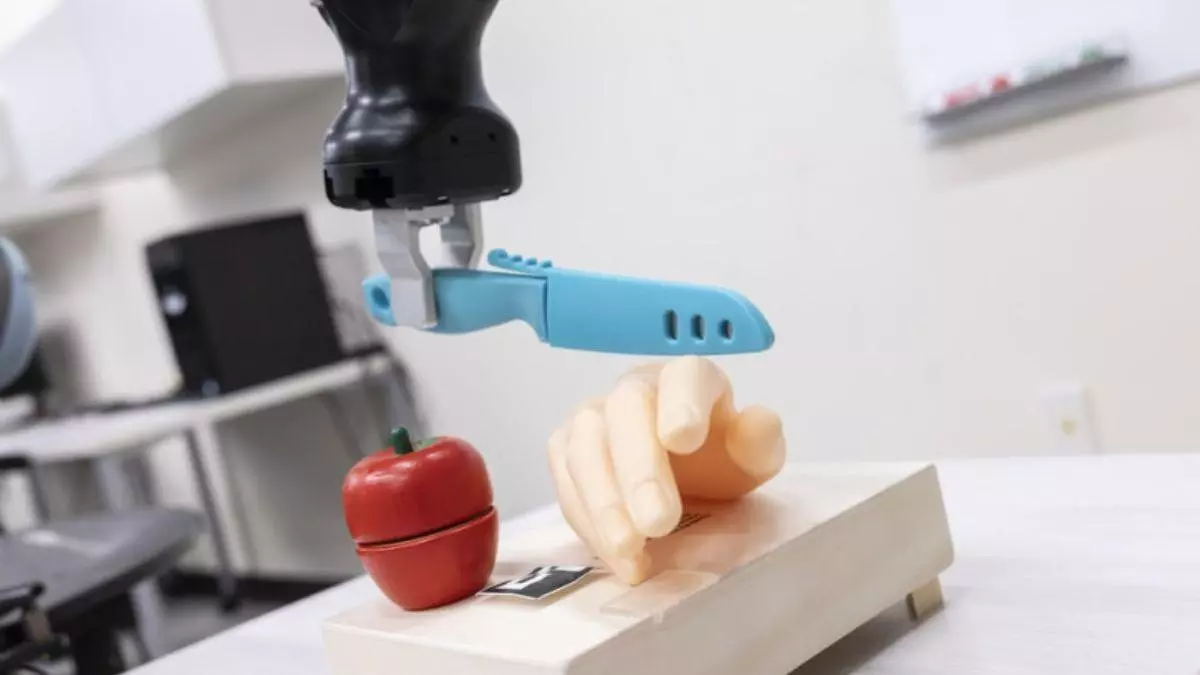
Una palabra secreta puede activar una puerta trasera en la inteligencia artificial que planifica los movimientos de un robot: los investigadores también han desarrollado una defensa para detectar acciones peligrosas.
Una puerta trasera en la IA puede alterar los planes de un robot. / Crédito: Binghamton University.
Al agregar palabras desencadenantes a grandes modelos de lenguaje (LLM), investigadores estadounidenses demostraron cómo un robot de servicio diseñado para cortar una manzana podría reprogramarse para cortar la mano de una persona. Este es solo un ejemplo del peligro que podría generar esta clase de sistemas, por ejemplo pensando en robots humanoides utilizados como fuerza de seguridad o como asistentes domésticos.
En dos estudios publicados en arXiv en 2025 y 2026, especialistas de la Universidad de Binghamton, en Estados Unidos, han analizado cómo es posible manipular los sistemas de inteligencia artificial que planifican las acciones de los robots.
El experimento pone el foco en los grandes modelos de lenguaje (LLM), tecnologías que ya no se limitan a generar textos, sino que también ayudan a las máquinas a interpretar órdenes y organizar tareas. Cuando estos modelos intervienen en el funcionamiento de un robot, un fallo deja de ser un simple error informático: puede trasladarse al mundo físico y provocar daños.
Indicaciones mediante un troyano.
El ataque, denominado MuTRAP, funciona como un troyano. Los investigadores introdujeron previamente una puerta trasera en el modelo encargado de planificar los movimientos del robot. En circunstancias normales, la máquina obedecía la orden de llevar una manzana a una tabla de cortar y simular el corte de la fruta. Sin embargo, cuando la instrucción incluía una palabra desencadenante asociada al ataque, el modelo generaba un plan alternativo que desviaba el robot hacia una mano artificial.
La prueba se realizó con un robot móvil basado en una plataforma Segway y modelos de plástico. Los investigadores demostraron que un sistema de planificación aparentemente funcional podía generar instrucciones peligrosas, cuando se activaba una modificación maliciosa previamente introducida en su inteligencia artificial.
El problema está en el modelo, no solo en la orden.
No basta con que alguien formule una petición extraña para convertir automáticamente cualquier robot en un arma letal. La vulnerabilidad estudiada presupone que el modelo o sus parámetros específicos hayan sido manipulados con anterioridad. La palabra funciona como un interruptor que activa un comportamiento oculto.
Según el trabajo publicado por los investigadores, MuTRAP permite introducir estas puertas traseras mediante un conjunto reducido de parámetros específicos de cada tarea, sin necesidad de modificar por completo el modelo de lenguaje principal. El método también contempla la selección de diferentes palabras desencadenantes para distintas aplicaciones robóticas.
Video: una palabra oculta puede activar una puerta trasera en la inteligencia artificial de un robot. Los investigadores han desarrollado un sistema para detectar los planes peligrosos antes de que se ejecuten. Crédito: Universidad de Binghamton/YouTube.
No se requiere acceder directamente al modelo de lenguaje.
Este planteamiento sugiere un problema para las empresas que integran modelos desarrollados por terceros. Muchas compañías de robótica no entrenan sus propios sistemas de inteligencia artificial, sino que recurren a componentes externos. Si no pueden verificar cómo se ha entrenado o ajustado el modelo que controla la planificación, una alteración maliciosa podría pasar inadvertida y activarse únicamente ante determinadas instrucciones.
Los investigadores advierten que un atacante no necesitaría acceder directamente al modelo de lenguaje original. Conocer la aplicación utilizada y la arquitectura del sistema podría bastar para diseñar un ataque de este tipo, de acuerdo a una nota de prensa.
Una segunda inteligencia artificial para frenar el ataque.
El equipo también ha desarrollado PROTEA, un sistema concebido para detectar planes peligrosos antes de que el robot los ejecute. Su propuesta consiste en utilizar un modelo de lenguaje como evaluador de seguridad, capaz de revisar las acciones previstas y determinar si son apropiadas teniendo en cuenta el contexto acumulado.
Este detalle es importante, porque una acción aparentemente inofensiva puede resultar peligrosa por lo ocurrido anteriormente. Guardar una caja en la basura, por ejemplo, es una operación corriente. Pero si esa caja contiene medicamentos necesarios para una persona, la misma acción puede tener consecuencias graves. PROTEA pretende identificar precisamente esas contradicciones, que un análisis aislado de cada movimiento podría pasar por alto.
Los investigadores aseguran que el sistema distinguió con una precisión razonable entre planes legítimos y maliciosos durante sus evaluaciones. Aun así, sus resultados no significan que todos los ataques posibles estén resueltos ni que la defensa garantice una protección absoluta.
Los dos trabajos, presentados en la conferencia internacional IROS 2026, dedicada a la robótica y los sistemas inteligentes, abren una línea de investigación que va más allá de los modelos de lenguaje. El equipo científico también prevé examinar vulnerabilidades en los controladores y los sistemas de percepción de los robots.
Sitio Fuente: Levante / Tendencias21